Agent 怎么记住你说过的话
前两天在本地把 Claude Code 的 API 地址指向了一个代理服务。新开会话,随口说,我是厦大 CS 的本科生,主攻 Java 后端和 AI,最近在给腾讯的开源项目提 PR。为了对照,还编了第三条,我特别爱喝手冲咖啡,每天下午三点准时下楼买一杯。
今天另起全新会话,上下文空白,问它,我下午三点一般干嘛。
它答,下午三点你一般会去楼下买一杯手冲咖啡。
新会话,零上下文,它凭什么记得。
这个系统叫 TencentDB-Agent-Memory,腾讯云今年开源的,GitHub 上 27.7k star。核心问题是让 Agent 的经验能留下来,不是每次对话结束就归零。
四层记忆怎么搭的
我天天用 Claude Code 和 Codex,它们的记忆很短,对话一关就忘。上下文窗口越来越大,但会话结束就清空,上周踩过的坑这周还会再踩。
TencentDB-Agent-Memory 的思路是在 Agent 和大模型之间插一层代理,对话流过时顺手把经验变成记忆。Agent 零代码接入,base URL 指过去就行。
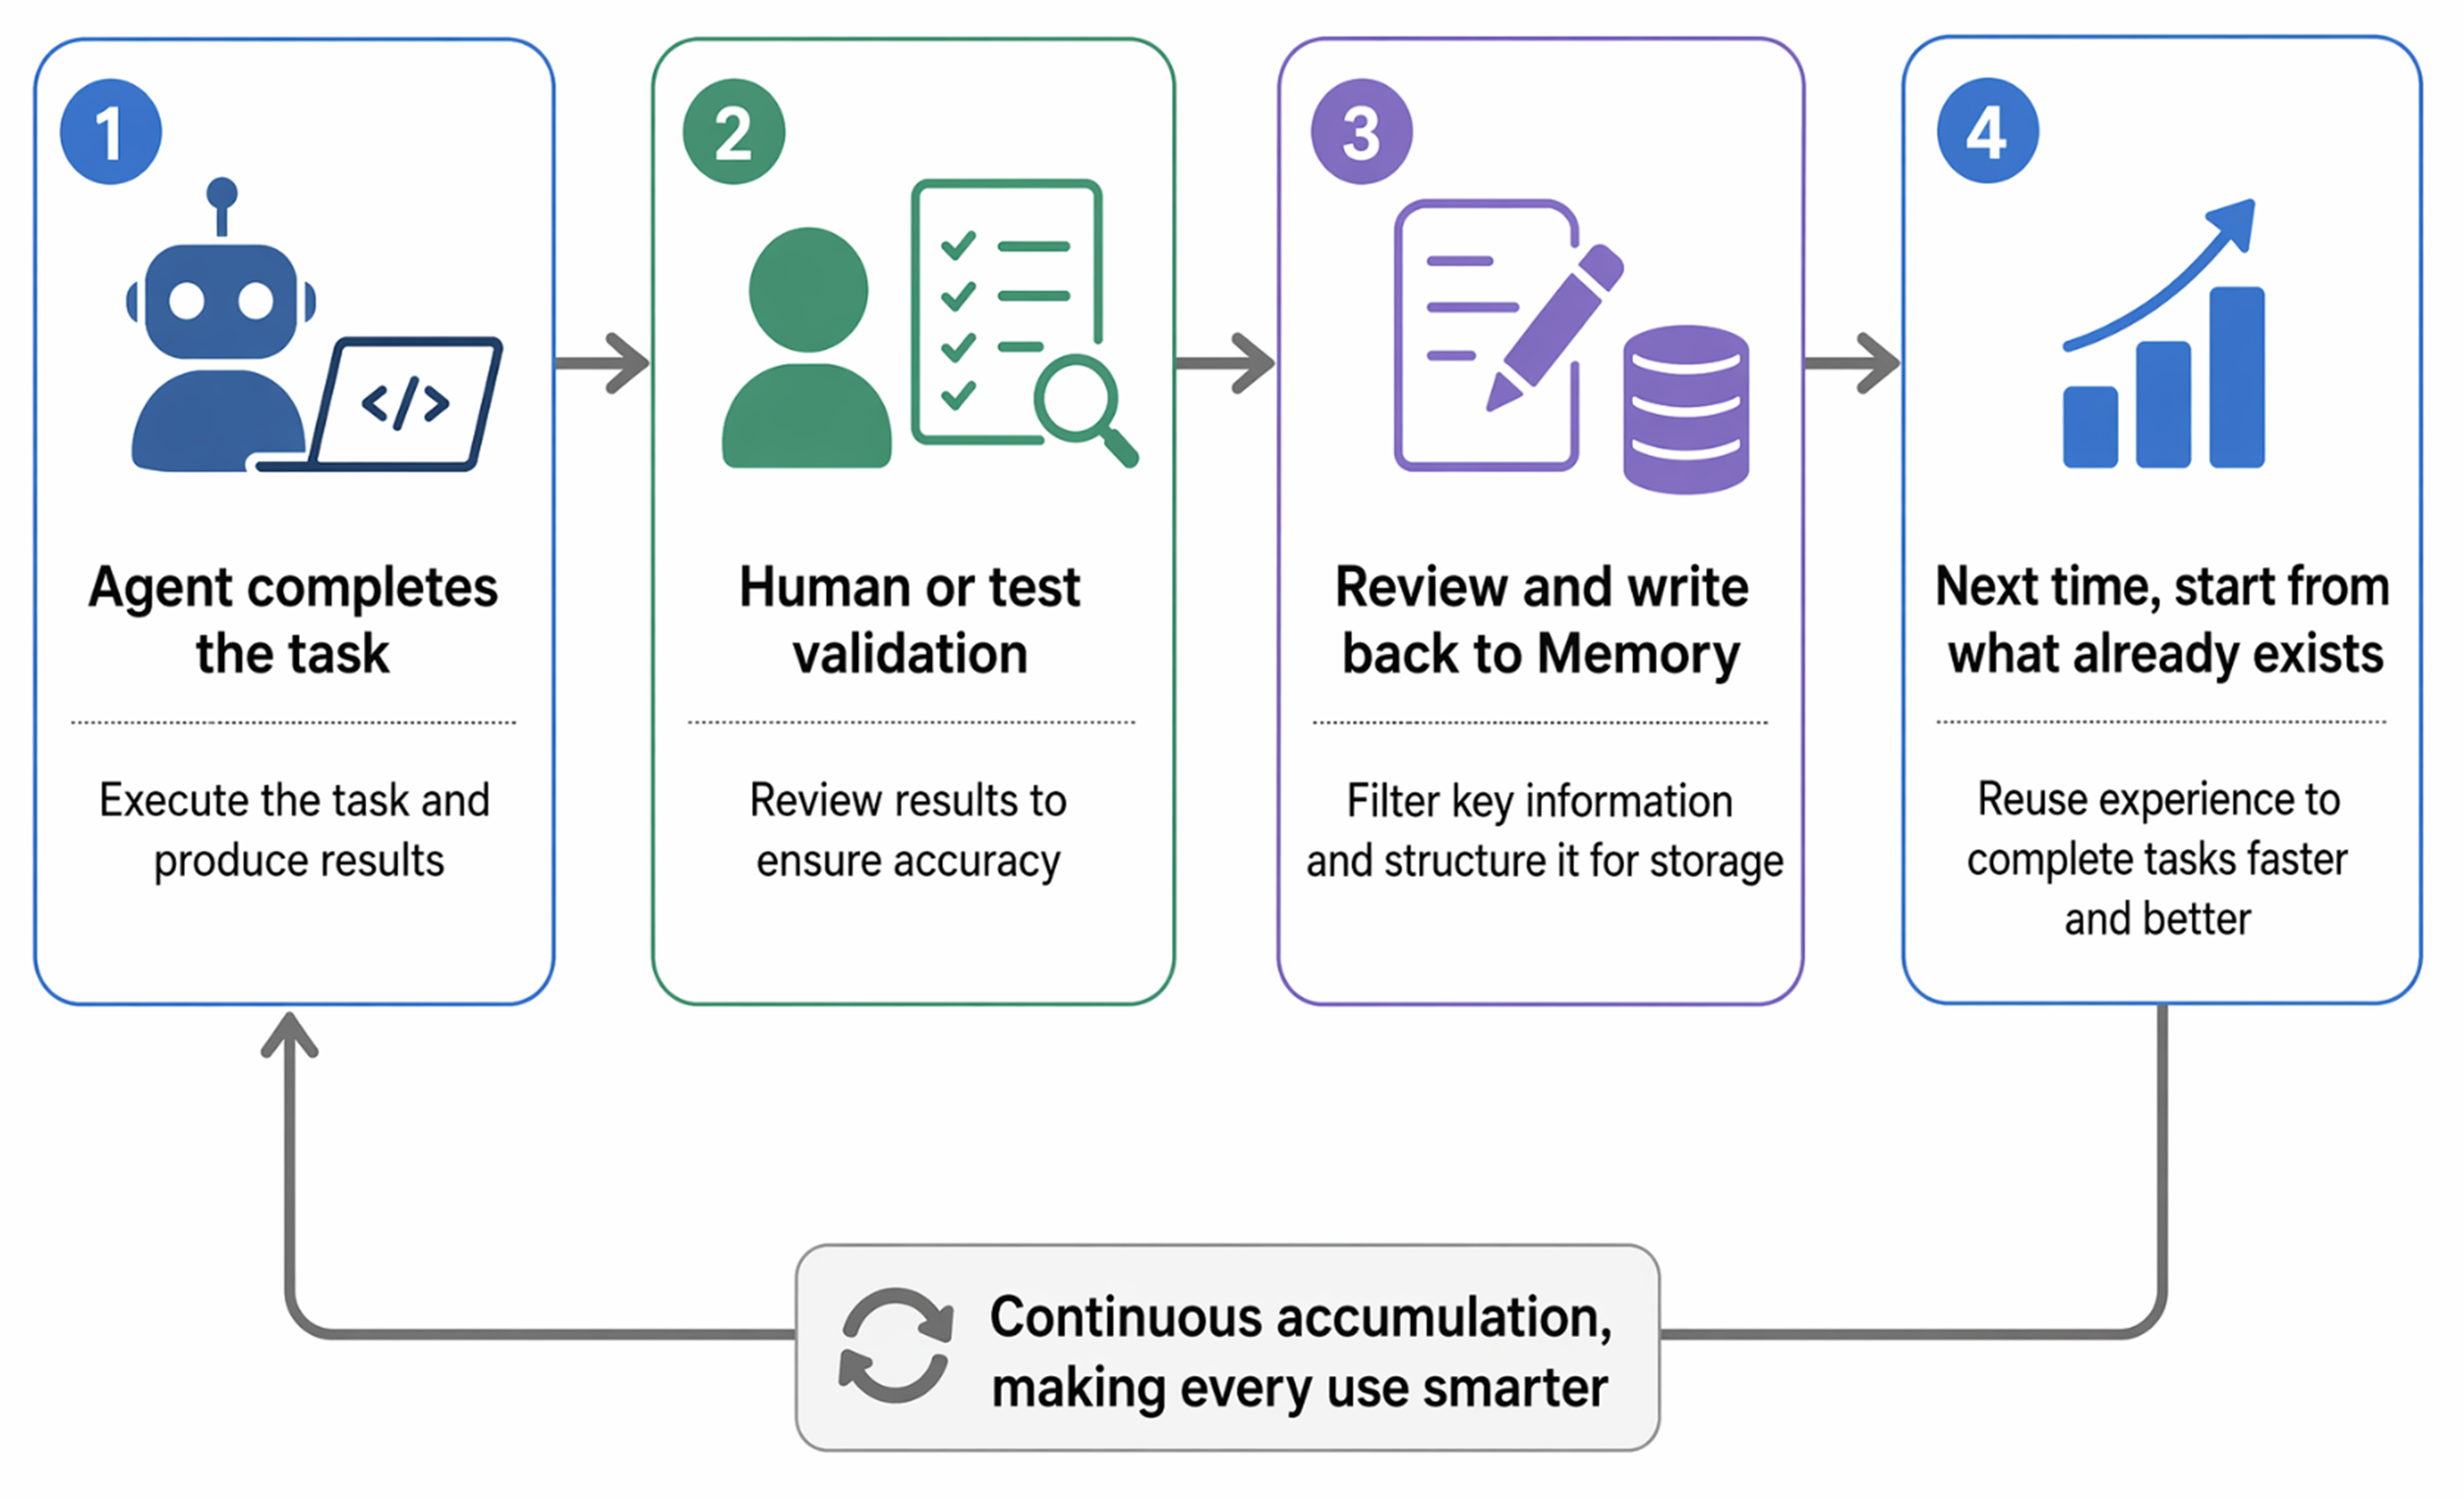
benchmark 里有 PersonaMem,测 Agent 能不能在长期交互后正确理解用户信息。不带记忆 48%,带上这套系统 76%。
L0 - 对话原文
对话原样落盘,每天一个文件,不压缩。保留完整上下文,可追溯原文,触发后续抽取流程。
对应认知科学里的工作记忆(Working Memory),容量有限但保留完整细节。
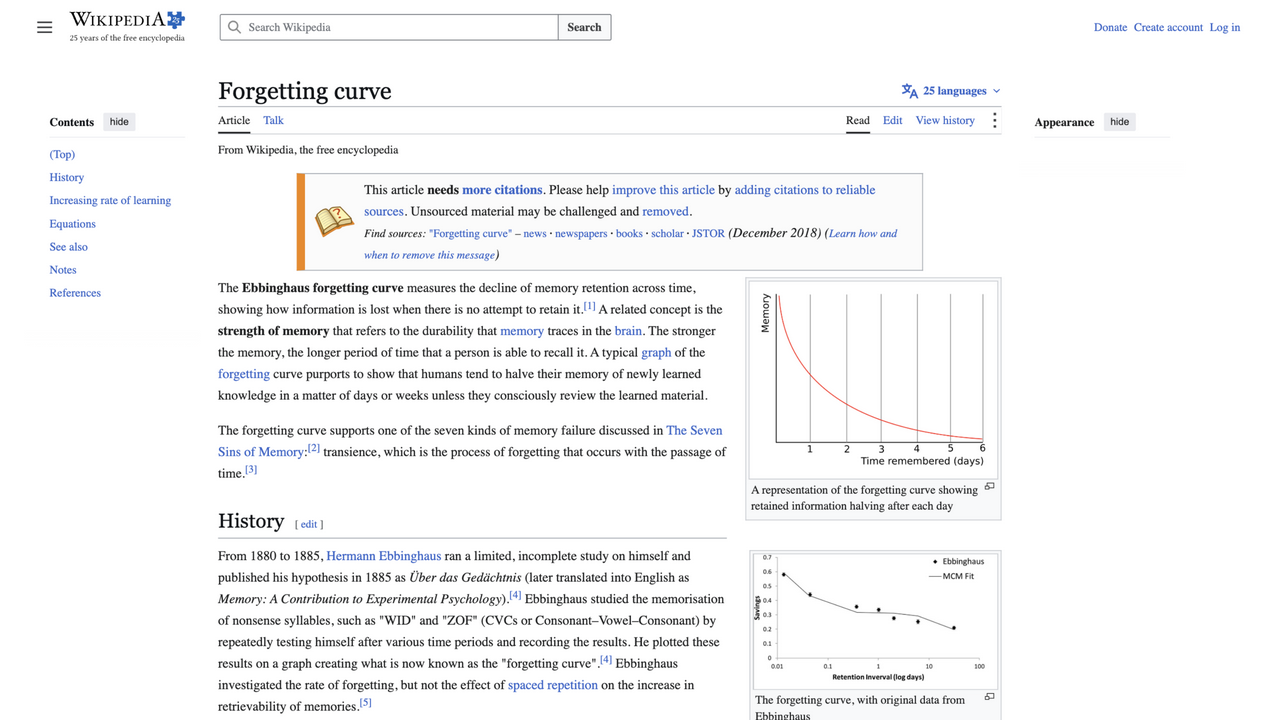 遗忘曲线显示记忆随时间快速衰减,Ebbinghaus (1885)
L1 - 原子记忆
一个大模型在一次调用里同时干两件事,先切情境,再从对话里把事实、偏好、约束拆出来,拆成独立的小卡片。
每条卡片有几条规矩。要独立完整,跳出对话还能成立。要带溯源 ID,能追回原文。宁缺毋滥,记错了比记不住更糟。
我实测时编了两条生活事实,结果没被提取出来。翻到提取 prompt 发现,工作模式下明确写着不提取与工作无关的个人偏好。
对应情景记忆(Episodic Memory)的编码过程,把经历拆解成可检索的单元。
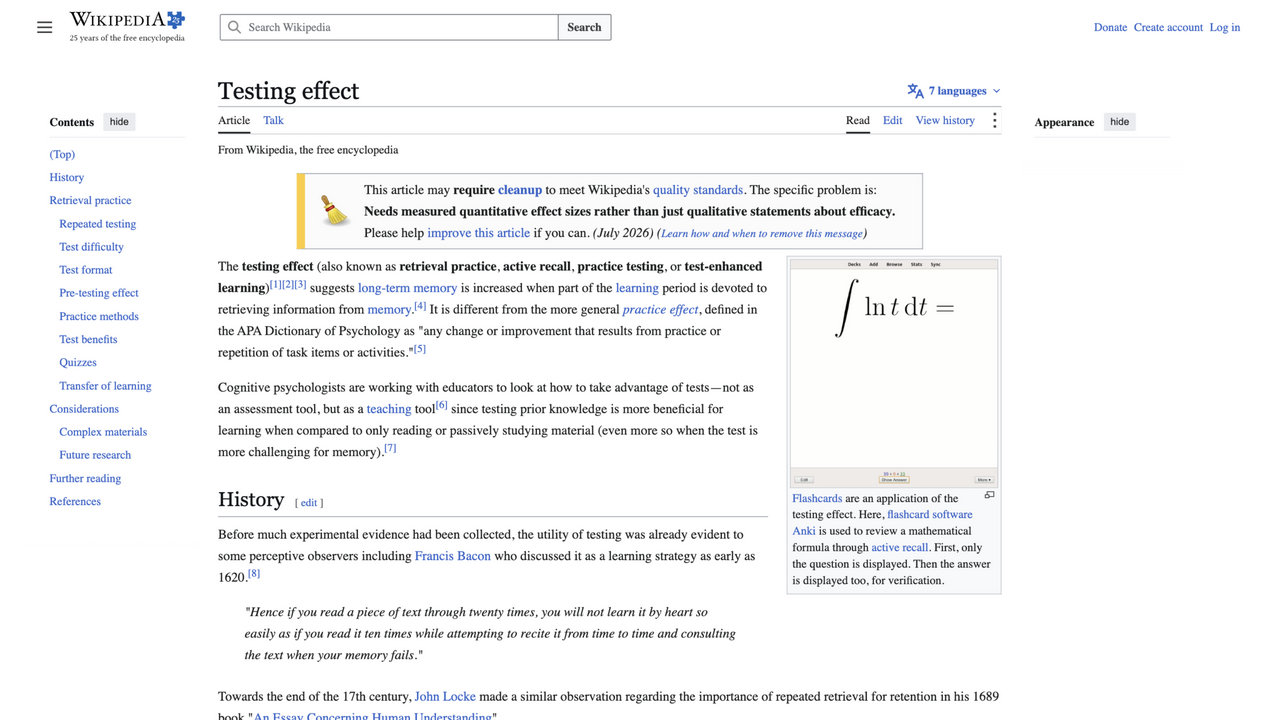 Testing Effect - 提取练习比重复学习更能增强长期记忆 (Roediger & Karpicke, 2006)
L2 - 场景记忆
把散落的 L1 卡片围绕项目整合成场景文件,每个场景带热度值,被翻牌越多越热。系统里跑这个活的 prompt 开头自称,记忆整合架构师,你不仅是记录数据,更像一位人类学家和心理学家。
对应语义记忆(Semantic Memory)的初步形成,将情景记忆抽象成知识。
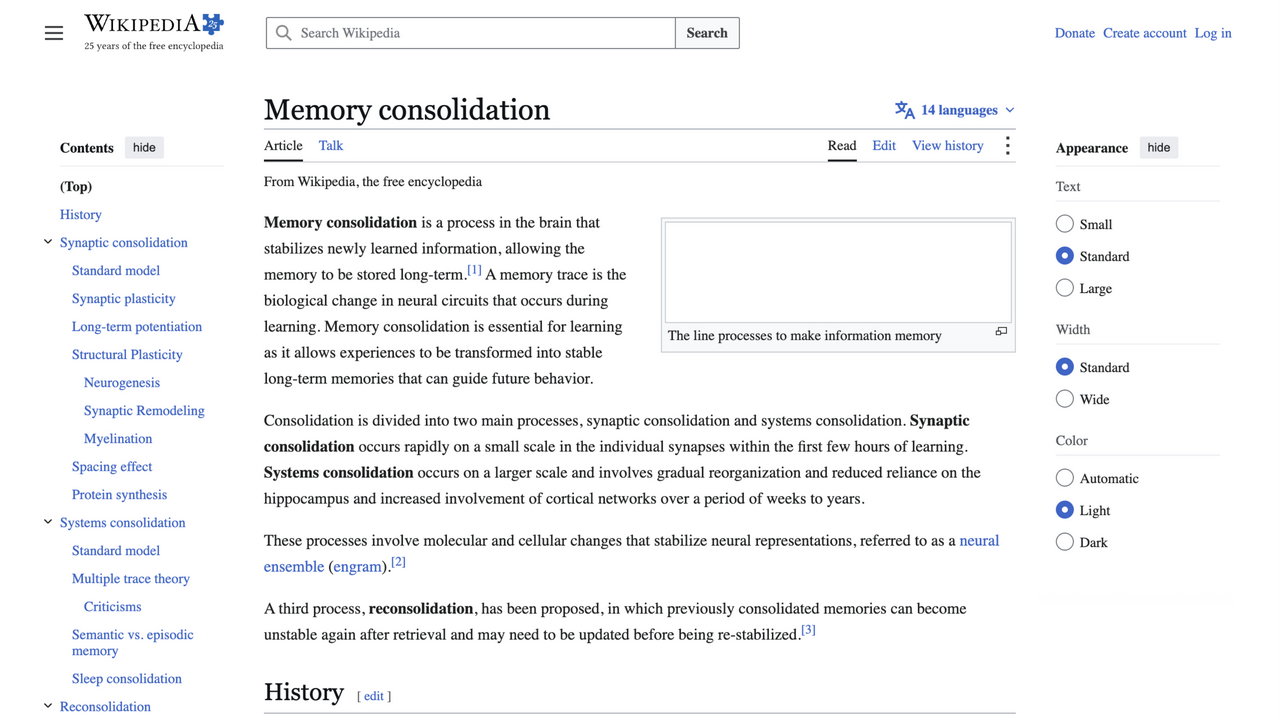 Memory Consolidation - 记忆从海马体转移到大脑皮层的巩固过程
L3 - 核心记忆
两千字符硬上限,装的是这个用户最稳定的画像,认知内核,最高层次的抽象。
对应长期记忆(Long-term Memory)中的核心人格和认知模式。
怎么用
四层分好之后,怎么用也有讲究。
L3 和 L2 直接拼进 system prompt,L1 包装成只读工具按需查询,L0 只在需要验证原文时才翻。
这么分是因为 system prompt 一动,大模型的 KV cache 就全废,每次对话的输入成本直接翻倍。稳定的东西钉死,易变的东西按需取。
记忆巩固流程
想起以前看的脑科学书。人的睡眠有个过程叫记忆巩固(Memory Consolidation),白天海马体匆匆记下的短暂痕迹,会在夜里被大脑离线重放,一遍遍重组,最后沉淀成皮层里的语义知识。
L0 到 L3 这条管线,相当于给 AI 做了一套睡眠机制。
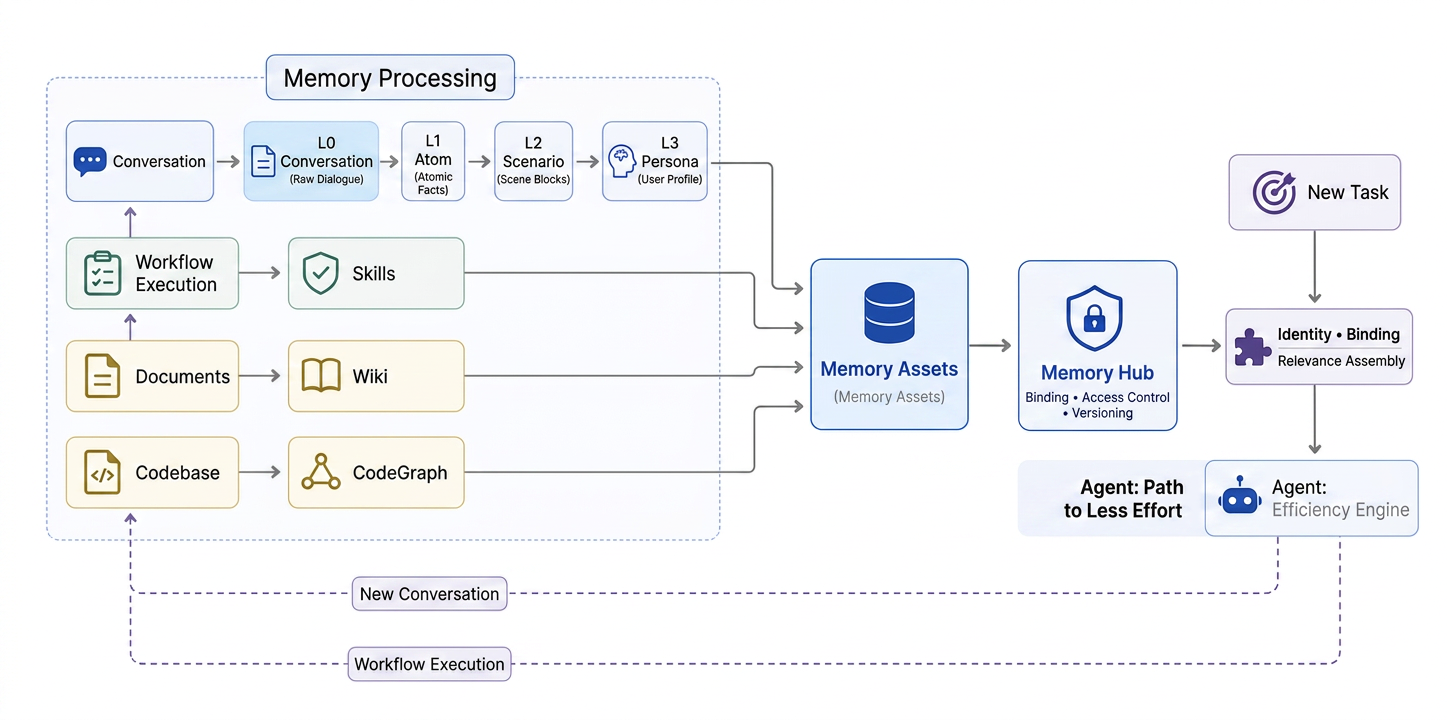
异步处理流程
1
2
3
4
5
6
7
8
9
10
11
对话发生 → L0 落盘
  ↓ (异步)
L1 抽取任务入队
  ↓
大模型:切情境 + 提取事实
  ↓
去重、冲突检测
  ↓
L2 场景整合
  ↓
L3 核心更新
这条流水线带着任务队列、分布式锁、失败重试、级联调度。
我实测那天盯着日志看它跑完这条流水线。那段随口说的三句话,先被 L0 原样落盘,几分钟后 L1 抽取任务自动入队。大模型把对话切成情境,情境名是「团队成员在介绍 TencentDB-Agent-Memory 项目工作背景」。然后抽取、去重、冲突检测,一路自动跑进 L2 的场景块。整个过程无需人工操作。
认知科学对应
| 认知科学概念 | Agent Memory 实现 |
|---|---|
| Working Memory | L0 Conversation |
| Encoding | L1 抽取 pipeline |
| Consolidation | L0→L1→L2→L3 异步流程 |
| Semantic Memory | L2 Scenario |
| Schema | L3 Core/Persona |
| Retrieval | BM25 + Vector + RRF |
加反馈强化
这套系统有个地方一直空着。它只管记,不管忘,也不会越用越准。
人脑不是这样的。心理学里有两个机制。
- 提取练习效应(Testing Effect),记忆每被成功提取一次,下次就更容易被想起来。
- 遗忘曲线(Forgetting Curve),不用的记忆会自然衰减。
两个机制合起来,人脑才能把有限的容量留给重要的内容。
这套系统检索只按相似度排序。一条记忆哪怕上周刚救过 Agent,今天检索时,它跟三个月没人碰过的记忆权重一样。
我提的 PR #1376 就干这个事,让 Agent 选中过的 L1 记忆被强化。
确认式使用记录
搜索结果带上记忆 ID,Agent 判断某条记忆真的支撑了这次回答,就回写一次使用记录。
注意,靠的是 Agent 主动确认,不是搜索 Top-K 回来就全部记为已使用。后者会把候选一起强化,几次搜索后大家都顶着时间戳,信号就稀释了。
重排打分
在这条记忆的原始相似度上,还要再叠两个轻量因子,一个管近因,一个管频次。
- 近因加成,14 天半衰期的指数衰减
1
recency_factor = exp(-days_since_last_use / 14)
- 频次加成,一个饱和函数,用得越多加分越多,但有上限
1
frequency_factor = tanh(use_count / 10)
最终得分是相似度乘上两个因子的加权和,两个权重都只给 0.1。
1
final_score = similarity * (1 + 0.1 * recency + 0.1 * frequency)
注释里写了四个字,use it or lose it。
Frame Gate
这是后来补的。
我把带强化的版本跑了三组对照实验,一百多个会话,同一个模型配对测。结果一半在预期内。正确反馈的场景,命中率涨了 8.3 个百分点。
另一半让我意外。在学过旧方案的场景里,反向暴跌 18.1 个点。
排查下来发现一个现象。那条记忆的内容写着「以前是这么做的」,查询问的是「现在该怎么做」。一个过时的历史方案,因为被翻牌多,反而压过了现行约定,冲到了最前面。
强化会放大所有内容,包括过时的。
心理学里对此有现成的概念。
- 编码特异性(Encoding Specificity),强化应该附着在使用的情境上。
- 干扰更新(Interference),新旧内容冲突时要分得出先后。
我最初只参考了提取练习和遗忘曲线,漏了这两条。
所以我加了第二版,叫 Frame Gate(时态门控)。一条记忆如果把自己描述成历史,以前、曾经、已废弃、后来改了,这类标记一出现,在现在式的查询里就撤回它的强化。只撤奖不惩罚,原始排序兜底。
1
2
3
4
5
6
7
8
9
10
11
12
def should_apply_reinforcement(memory, query):
    # 检测历史标记
    historical_markers = ['以前', '曾经', '已废弃', '后来改了', 'deprecated']
    has_historical_marker = any(marker in memory.content for marker in historical_markers)

    # 检测查询时态
    is_present_query = any(word in query for word in ['现在', '目前', '当前', 'now'])

    # 历史记忆 + 现在式查询 → 撤回强化
    if has_historical_marker and is_present_query:
        return False
    return True
实验结果
改完再跑一遍那组实验。
| 配置 | PersonaMem准确率 | 提升 |
|---|---|---|
| 不带强化(基线) | 72.4% | - |
| 只带强化 | 76.3% | +3.9% |
| 强化 + Frame Gate | 84.2% | +11.8% |
退化场景全部转正,两个不同的模型上方向一致。
说句实话,这套基准是我自己造的合成评测,不是线上真实收益,PR 里也是这么标注的。数字看方向就好。
实现细节
存储结构
在 L1 原子记忆表里加了三个字段。
1
2
3
4
5
6
7
8
9
10
interface AtomicMemory {
  // ... 原有字段
  use_count: number;           // 累计使用次数
  last_used_at: Date | null;   // 最近使用时间
  use_history: Array<{         // 使用历史(可选,用于debug)
    timestamp: Date;
    agent_id: string;
    session_id: string;
  }>;
}
确认式反馈接口
新增一个 API 端点。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
POST /v3/atomic/mark-used

Request:
{
  memory_ids: string[],        // Agent 确认使用的记忆 ID
  agent_id: string,
  session_id: string,
  timestamp: Date
}

Response:
{
  updated_count: number,
  failed_ids: string[]
}
这个接口由 Proxy 在收到 Agent 响应后调用。Agent 通过特殊标记告知 Proxy 哪些记忆真正被使用。
检索重排逻辑
修改 L1 检索的打分函数,近因和频次两个因子都叠在这一层,Frame Gate 也在这里拦一道。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
function rerankWithReinforcement(
  results: SearchResult[],
  config: { recencyWeight: 0.1, frequencyWeight: 0.1, halfLife: 14 }
): SearchResult[] {
  return results.map(r => {
    const memory = r.memory;

    // 计算近因因子
    const daysSinceUse = memory.last_used_at
      ? (Date.now() - memory.last_used_at.getTime()) / (1000 * 60 * 60 * 24)
      : Infinity;
    const recencyFactor = Math.exp(-daysSinceUse / config.halfLife);

    // 计算频次因子
    const frequencyFactor = Math.tanh(memory.use_count / 10);

    // Frame Gate 检查
    const shouldReinforce = checkFrameGate(memory, r.query);

    // 最终得分
    const reinforcementBoost = shouldReinforce
      ? config.recencyWeight * recencyFactor + config.frequencyWeight * frequencyFactor
      : 0;

    return {
      ...r,
      score: r.similarity * (1 + reinforcementBoost),
      debug: { recencyFactor, frequencyFactor, reinforcementApplied: shouldReinforce }
    };
  }).sort((a, b) => b.score - a.score);
}

function checkFrameGate(memory: AtomicMemory, query: string): boolean {
  const historicalMarkers = ['以前', '曾经', '已废弃', '后来改了', 'deprecated', 'was', 'used to'];
  const presentMarkers = ['现在', '目前', '当前', 'now', 'current', 'currently'];

  const hasHistorical = historicalMarkers.some(m => memory.content.includes(m));
  const isPresent = presentMarkers.some(m => query.includes(m));

  // 历史记忆遇到现在式查询,撤回强化
  return !(hasHistorical && isPresent);
}
Proxy 集成
最后在 Proxy 层把反馈回路接上。Agent 流式返回的每一段都过一遍,确认用过的记忆 ID 攒在一起,等这一轮结束再统一回写。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
async function handleStreamResponse(stream, context) {
  const usedMemoryIds = new Set<string>();

  for await (const chunk of stream) {
    if (chunk.type === 'memory_usage') {
      chunk.memory_ids.forEach(id => usedMemoryIds.add(id));
    }
    yield chunk;
  }

  if (usedMemoryIds.size > 0) {
    await memoryCore.markMemoriesUsed({
      memory_ids: Array.from(usedMemoryIds),
      agent_id: context.agentId,
      session_id: context.sessionId,
      timestamp: new Date()
    });
  }
}
设计原理
为什么是确认式,不是被检索即使用
最简单的做法是被检索即使用,搜出 Top-10 就全部标记为使用,这样会带来两个问题。
- 噪音放大,候选记忆也被强化,几轮后所有候选都顶着高分,区分度消失。
- 无法反映真实价值,Agent 看到了但没用,说明这条记忆对当前任务价值不大。
确认式反馈保证的是另一件事,只有产生了作用的记忆才配被强化。
为什么权重只有 0.1
强化是辅助信号,不是主导因素。相似度仍然是第一位的,强化只是在相似度接近时的打分器。
如果权重过大(比如 0.5),会导致两个问题。
- 高频记忆压制新鲜但相关的记忆
- 系统过度依赖历史,失去适应性
0.1 是实验出来的平衡点,既能让常用记忆上浮,又不会掩盖语义相关性。
为什么需要 Frame Gate
这是最关键的设计。没有它,强化机制会形成正反馈。
1
旧方案被使用 → 得分上升 → 更容易被检索 → 更容易被使用 → 得分继续上升
即使旧方案已经废弃,它仍然会因为历史频繁使用而霸榜。
Frame Gate 用来打断这个循环。当记忆内容本身标明这是历史,而查询问的是现状,系统就暂停强化,让相似度重新主导。
这对应认知科学里的情境依赖记忆(Context-Dependent Memory)。记忆的提取应该匹配编码时的情境,历史记忆不应该在现在式查询中获得不当优势。
后续方向
更细粒度的时态识别
当前的 Frame Gate 用关键词匹配,比较粗糙。可以改进的方向有三个。
- 用 NLI 模型判断记忆和查询的时态一致性
- 提取记忆的有效期(validity period)
- 在 L1 抽取时就标注时间范围
协同过滤
当前只看单条记忆的使用历史。可以加入的有这些。
- 相似记忆的共现模式
- 同一 Agent 的偏好学习
- 团队级别的记忆热度共享
主动遗忘
当前只是降权,没有真的删除。可以加入的有这些。
- 长期未使用且低分的记忆自动归档
- 冲突记忆的主动合并或淘汰
- 用户可设置的记忆保留策略
1885 年 Ebbinghaus 用无意义音节测出了第一条遗忘曲线。做这个 PR 时,我用到的工作记忆、情景记忆、巩固、遗忘,都是认知科学里的现成概念,在这里变成了代码里的模块和函数。
项目的 slogan 是,让 Agent 沉淀经验,让人专注创造。
参考资料
- TencentDB-Agent-Memory GitHub
- PersonaMem Benchmark
- Ebbinghaus, H. (1885). Memory. A Contribution to Experimental Psychology
- Roediger, H. L., & Karpicke, J. D. (2006). Test-enhanced learning. Taking memory tests improves long-term retention. Psychological Science
- Tulving, E. (1972). Episodic and semantic memory. Organization of memory
- Dudai, Y. (2004). The neurobiology of consolidations, or, how stable is the engram?. Annual Review of Psychology
- Pashler, H., Rohrer, D., Cepeda, N. J., & Carpenter, S. K. (2007). Enhancing learning and retarding forgetting. Choices and consequences. Psychonomic Bulletin & Review
- Murre, J. M., & Dros, J. (2015). Replication and Analysis of Ebbinghaus’ Forgetting Curve. PLOS ONE